Die künstliche Intelligenz hat innerhalb kürzester Zeit Einzug in unseren Berufsalltag gehalten. Leistungsfähige Large Language Models (LLMs) wie ChatGPT, Claude oder Gemini ermöglichen es, umfangreiche Dokumente zu analysieren, komplexe Sachverhalte zusammenzufassen, Texte zu formulieren oder Entscheidungsgrundlagen aufzubereiten.
Was früher mehrere Stunden in Anspruch nahm, lässt sich heute oftmals innerhalb weniger Minuten erledigen.
Doch bei aller Begeisterung über diese technologischen Möglichkeiten wird ein wesentlicher Aspekt häufig unterschätzt: Welche Informationen dürfen wir überhaupt an externe KI-Systeme übermitteln?
Aus meiner Tätigkeit als IT-Sachverständiger weiß ich, dass Informationssicherheit nicht erst bei der technischen Absicherung eines Systems beginnt. Sie beginnt bereits bei der Entscheidung, welche Daten ein Unternehmen oder eine Organisation an externe Dienstleister weitergibt.
Gerade beim Einsatz generativer künstlicher Intelligenz ist diese Frage von besonderer Bedeutung.
1. Ein Prompt ist mehr als eine einfache Frage
Wer eine Anfrage an ein externes Sprachmodell stellt, übermittelt häufig weit mehr Informationen, als ihm bewusst ist.
Ein typisches Beispiel aus dem Berufsalltag:
Ein Mitarbeiter möchte einen umfangreichen Personalakt zusammenfassen lassen und lädt dazu das gesamte PDF-Dokument in ein KI-System hoch.
Das Dokument enthält möglicherweise Namen, Adressen, Geburtsdaten, Gehaltsinformationen, Krankenstände oder dienstrechtliche Beurteilungen.
Das Sprachmodell kann daraus innerhalb weniger Sekunden eine ausgezeichnete Zusammenfassung erstellen.
Technisch funktioniert dieser Vorgang beeindruckend.
Aus Sicht des Datenschutzes und der Informationssicherheit kann diese Vorgehensweise jedoch höchst problematisch sein.
Denn mit dem Hochladen des Dokuments werden die darin enthaltenen Informationen an einen externen Anbieter übermittelt. Je nach gewähltem Dienst, Vertrag und Konfiguration können unterschiedliche Regelungen zur Verarbeitung, Speicherung und Verwendung dieser Daten gelten.
Dabei ist eines besonders wichtig: Die Tatsache, dass ein KI-Anbieter verspricht, eingegebene Informationen nicht für das Training seiner Modelle zu verwenden, bedeutet noch lange nicht, dass die Übermittlung sämtlicher vertraulicher Daten zulässig oder risikofrei ist.
2. Anonymisierung und Pseudonymisierung – ein entscheidender Unterschied
Im Zusammenhang mit der Nutzung externer Sprachmodelle werden diese beiden Begriffe häufig synonym verwendet.
Rechtlich und technisch bestehen jedoch erhebliche Unterschiede.
Anonymisierung
Bei einer tatsächlichen Anonymisierung werden personenbezogene Informationen so verändert oder entfernt, dass eine Identifizierung der betroffenen Personen auch unter Berücksichtigung vernünftigerweise verfügbarer Zusatzinformationen und Mittel nicht mehr möglich ist.
Beispiel:
Originaltext:
„Herr Max Mustermann, geboren am 15. März 1975, wohnhaft in der Musterstraße 12 in Klagenfurt, erhielt im Jahr 2025 eine Gehaltserhöhung von 8,5 Prozent.“
Anonymisierte Fassung:
„Ein Mitarbeiter der untersuchten Organisation erhielt im Jahr 2025 eine Gehaltserhöhung von 8,5 Prozent.“
Für eine KI-gestützte sprachliche Überarbeitung oder eine allgemeine Beurteilung der Gehaltserhöhung ist die Identität der Person in vielen Fällen vollkommen unerheblich.
Entscheidend ist jedoch, dass auch der verbleibende Kontext keine Identifizierung ermöglicht. In einem sehr kleinen Unternehmen könnte beispielsweise bereits die Kombination aus Funktion, Zeitraum und Gehaltserhöhung einen Rückschluss auf eine bestimmte Person erlauben.
Pseudonymisierung
Bei der Pseudonymisierung werden identifizierende Informationen durch künstliche Kennzeichnungen ersetzt.
Beispiel:
Originaltext:
„Max Mustermann erhielt am 15. März 2025 eine Gehaltserhöhung von 8,5 Prozent.“
Pseudonymisierte Fassung:
„Mitarbeiter P-104 erhielt im März 2025 eine Gehaltserhöhung von 8,5 Prozent.“
Die Zuordnung zwischen „P-104“ und der tatsächlichen Person wird getrennt und geschützt innerhalb der eigenen Organisation aufbewahrt.
Der Vorteil dieser Vorgehensweise liegt darin, dass sich komplexe Sachverhalte weiterhin analysieren lassen, ohne die tatsächliche Identität unmittelbar offenzulegen.
Allerdings gilt eine wichtige Einschränkung:
Pseudonymisierte Daten bleiben grundsätzlich personenbezogene Daten und unterliegen weiterhin der Datenschutz-Grundverordnung (DSGVO).
Dies wird auch von der Europäischen Kommission ausdrücklich hervorgehoben.
Eine Pseudonymisierung ist somit eine wichtige technische und organisatorische Schutzmaßnahme, aber kein Ersatz für die Prüfung der datenschutzrechtlichen Zulässigkeit einer Datenverarbeitung.
3. Fünf Beispiele aus dem beruflichen Alltag
Wie lässt sich diese Vorgehensweise konkret umsetzen?
Beispiel 1: Personalverwaltung
Aufgabenstellung: Ein Unternehmen möchte mittels KI Auffälligkeiten bei Überstunden analysieren.
Problematische Eingabe:
„Analysiere die Überstunden von Max Mustermann, Personalnummer 4711, wohnhaft in Klagenfurt, mit einem Monatsgehalt von 4.800 Euro.“
Datenschutzfreundlichere Eingabe:
„Analysiere die Überstunden des Mitarbeiters P-4711 mit 42 Überstunden im Monat und einer vertraglichen Normalarbeitszeit von 40 Wochenstunden.“
Für die Erkennung einer möglichen Überstundenanomalie sind weder der Name noch die Wohnadresse erforderlich.
Die eigentliche Analysequalität wird durch die Entfernung dieser Informationen in der Regel nicht beeinträchtigt.
Beispiel 2: Medizinische Dokumente
Aufgabenstellung: Eine Arztpraxis möchte einen medizinischen Bericht sprachlich verbessern.
Problematische Eingabe:
„Überarbeite den Befund von Maria Huber, geboren am 12. Juni 1968, Sozialversicherungsnummer 1234…, mit der Diagnose …“
Datenschutzfreundlichere Eingabe:
„Überarbeite folgenden medizinischen Befund einer Patientin im Alter zwischen 55 und 65 Jahren. Entferne identifizierende Angaben und behalte ausschließlich die für die fachliche Formulierung erforderlichen medizinischen Informationen bei.“
Gerade medizinische Informationen gehören zu den besonders schützenswerten personenbezogenen Daten nach Artikel 9 DSGVO.
Hier ist besondere Vorsicht geboten. Auch eine altersmäßige Verallgemeinerung und das Entfernen des Namens garantieren noch keine vollständige Anonymität.
Für solche Anwendungsfälle sind besonders geschützte, vertraglich und technisch abgesicherte KI-Umgebungen oder interne KI-Systeme häufig die geeignetere Lösung.
Beispiel 3: Öffentliche Verwaltung
Aufgabenstellung: Ein Verwaltungsmitarbeiter möchte einen Bescheidentwurf durch ein Sprachmodell auf Verständlichkeit prüfen lassen.
Problematische Eingabe:
„Prüfe den Bescheid betreffend Herrn Max Mustermann, wohnhaft in der Musterstraße 12, Aktenzahl XY-1234, hinsichtlich seiner Anspruchsberechtigung.“
Datenschutzfreundlichere Eingabe:
„Prüfe die sprachliche Verständlichkeit eines Bescheidentwurfs zu einer anonymisierten Förderangelegenheit. Die antragstellende Person wird als Antragsteller A bezeichnet.“
Für eine sprachliche Prüfung ist die konkrete Identität normalerweise nicht relevant.
Bei einer rechtlichen Analyse muss zusätzlich geprüft werden, welche Sachverhaltsdetails erforderlich sind. Vertrauliche Akteninhalte dürfen nicht allein deshalb an externe KI-Systeme übertragen werden, weil Namen entfernt wurden.
Beispiel 4: Rechtsberatung und Sachverständigentätigkeit
Aufgabenstellung: Ein Sachverständiger möchte einen umfangreichen technischen Sachverhalt strukturiert zusammenfassen lassen.
Problematische Eingabe:
„Analysiere das Gutachten über den Sicherheitsvorfall bei der Firma XY GmbH einschließlich aller Servernamen, IP-Adressen, Benutzerkonten und Zugangsdaten.“
Datenschutzfreundlichere Eingabe:
„Analysiere einen technischen Sicherheitsvorfall in einem mittelständischen Unternehmen. Das betroffene System wird als SERVER-A, das Benutzerkonto als USER-01 und die Organisation als UNTERNEHMEN-A bezeichnet.“
Besondere Vorsicht ist hier bei technischen Identifikatoren geboten.
Interne IP-Adressen, Hostnamen, Netzwerkpläne und Sicherheitskonfigurationen sind zwar nicht automatisch personenbezogene Daten, können aber sicherheitskritische Informationen darstellen.
Datenschutz und Informationssicherheit sind zwei unterschiedliche, aber eng miteinander verbundene Schutzbereiche.
Auch Informationen ohne Personenbezug können Geschäftsgeheimnisse enthalten oder Angreifern wertvolle Hinweise liefern.
Beispiel 5: Rechnungsprüfung und Controlling
Aufgabenstellung: Eine Organisation möchte Rechnungen automatisiert auf Plausibilität überprüfen.
Problematische Eingabe:
„Prüfe die Rechnung der Firma Muster GmbH an Herrn Max Mustermann mit IBAN AT…, Rechnungsnummer 2026-12345 und den folgenden Leistungen.“
Datenschutzfreundlichere Eingabe:
„Prüfe eine Rechnung eines externen Dienstleisters über 12.500 Euro für 25 Beratertage auf rechnerische Plausibilität und mögliche Auffälligkeiten bei den Leistungspositionen.“
Die für eine Plausibilitätsprüfung notwendigen Informationen bleiben erhalten.
Personenbezogene Daten, Bankverbindungen und sonstige nicht erforderliche Identifikatoren werden hingegen vor der Übermittlung entfernt.
Wichtig ist, dass diese Datenbereinigung bereits innerhalb der eigenen, vertrauenswürdigen IT-Umgebung erfolgt.
4. Warum das nachträgliche Löschen nicht ausreicht
Ein häufiges Missverständnis besteht darin, dass sich Datenschutzprobleme durch das spätere Löschen einer KI-Unterhaltung vollständig beseitigen lassen.
Das ist nicht zwingend der Fall.
Welche Daten nach dem Löschen eines Chats noch verarbeitet oder gespeichert werden, hängt insbesondere von den technischen und vertraglichen Rahmenbedingungen des verwendeten Dienstes ab.
Zu berücksichtigen sind beispielsweise:
- Aufbewahrungsfristen für Eingaben, Ausgaben und Protokolldaten.
- Verarbeitung durch externe Dienstleister oder Unterauftragsverarbeiter.
- Technische und organisatorische Sicherheitsmaßnahmen.
- Mögliche Drittlandübermittlungen.
- Einstellungen zur Nutzung von Daten für Modellverbesserungen.
- Vertragliche Vereinbarungen über die Datenverarbeitung.
Die entscheidende Sicherheitsmaßnahme muss daher möglichst vor der Übermittlung an das externe Sprachmodellstattfinden.
5. Warum eine einfache Schwärzung häufig nicht genügt
Besonders kritisch sehe ich die Vorstellung, dass das Entfernen von Namen bereits eine ausreichende Anonymisierung darstellt.
Ein Beispiel:
„Der 58-jährige Leiter der IT-Abteilung einer kleinen österreichischen Gemeinde mit 3.200 Einwohnern wurde am 1. Oktober 2026 pensioniert.“
Obwohl kein Name genannt wird, kann die betroffene Person anhand der Kombination aus Funktion, Gemeindegröße, Alter und Zeitpunkt unter Umständen relativ einfach identifiziert werden.
Man spricht in diesem Zusammenhang von einem Re-Identifizierungsrisiko.
Moderne KI-Systeme können Informationen miteinander verknüpfen und Zusammenhänge erkennen. Gerade diese Fähigkeit macht sie so leistungsfähig.
Sie führt aber auch dazu, dass die Kombination vermeintlich harmloser Einzelinformationen eine Identifizierung ermöglichen kann.
Eine professionelle Anonymisierung muss daher stets den Gesamtkontext berücksichtigen.
Der Europäische Datenschutzausschuss hat sich in seiner Stellungnahme 28/2024 mit den datenschutzrechtlichen Anforderungen an KI-Modelle und der Frage auseinandergesetzt, wann solche Modelle als anonym betrachtet werden können. Dabei wird insbesondere die Bedeutung einer fallbezogenen Bewertung hervorgehoben.
6. Die technische Lösung: Eine Anonymisierungsschicht vor dem Sprachmodell
Aus meiner Sicht besteht eine wesentliche Aufgabe moderner Unternehmens-IT darin, den Einsatz generativer künstlicher Intelligenz nicht ausschließlich über organisatorische Verbote zu steuern.
Stattdessen sollten technische Schutzmechanismen geschaffen werden, die eine sichere und kontrollierte Nutzung ermöglichen.
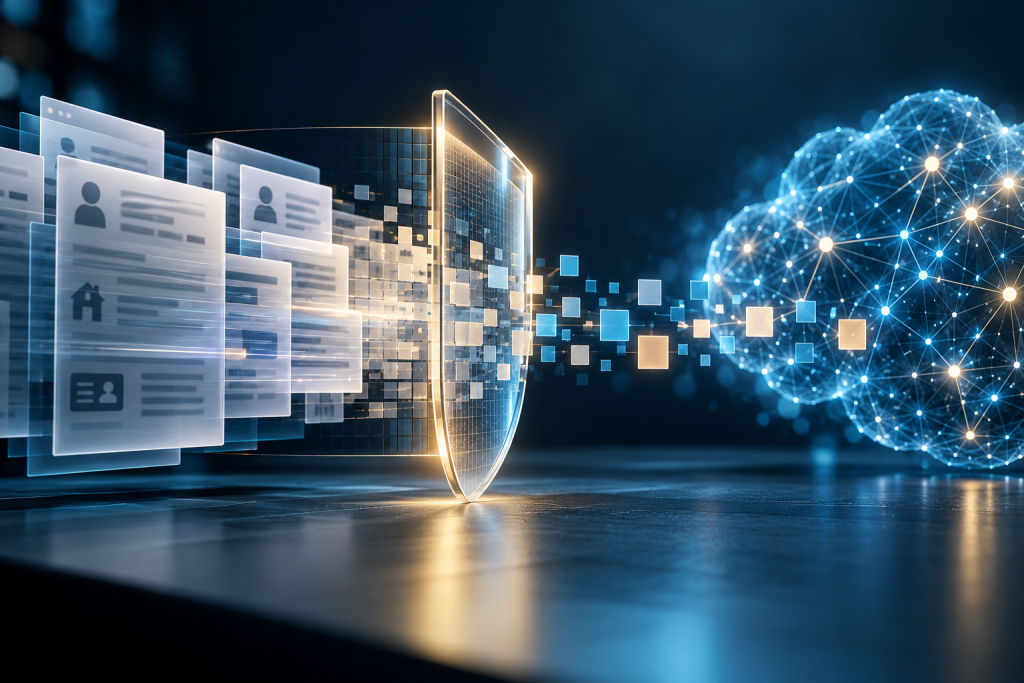
Ein möglicher Ansatz ist die Integration einer zentralen Anonymisierungs- beziehungsweise Pseudonymisierungsschicht.
Der technische Ablauf könnte folgendermaßen aussehen:
Schritt 1 – Eingabe innerhalb der Organisation
Ein Mitarbeiter übermittelt einen Text oder ein Dokument an eine interne KI-Anwendung.
Schritt 2 – Automatische Analyse
Eine vorgeschaltete Komponente untersucht den Inhalt auf schützenswerte Informationen.
Hierzu zählen beispielsweise personenbezogene Daten, Kontoinformationen, Identifikationsnummern, vertrauliche Unternehmensinformationen oder sicherheitsrelevante technische Angaben.
Schritt 3 – Anonymisierung oder Pseudonymisierung
Die erkannten Informationen werden abhängig vom Anwendungsfall entfernt, verallgemeinert oder durch neutrale Kennzeichnungen ersetzt.
Schritt 4 – Kontrollierte Übermittlung
Erst danach werden die bereinigten Informationen über eine freigegebene Schnittstelle an das externe Sprachmodell übertragen.
Schritt 5 – Verarbeitung der Antwort
Das Sprachmodell liefert sein Ergebnis zurück.
Bei einer Pseudonymisierung kann die interne Anwendung gegebenenfalls die ursprünglichen Bezeichnungen wiederherstellen.
Die hierfür erforderliche Zuordnungstabelle verbleibt ausschließlich innerhalb der vertrauenswürdigen IT-Infrastruktur.
Damit könnte beispielsweise ein externer LLM eine Verwaltungsentscheidung sprachlich überarbeiten, ohne dass ihm die Identität der betroffenen Bürger bekannt sein muss.
Wesentlich ist allerdings, dass solche Schutzmechanismen getestet werden. Automatische Erkennungssysteme sind nicht fehlerfrei und können sensible Informationen übersehen.
Insbesondere bei vertraulichen oder besonders schützenswerten Daten ist daher eine zusätzliche Kontrolle notwendig.
7. Externe KI oder eigenes Sprachmodell?
Eine weitere strategische Überlegung betrifft die Frage, ob externe Sprachmodelle für sämtliche Anwendungsfälle überhaupt die richtige Lösung darstellen.
Externe KI-Dienste bieten vielfach eine hervorragende Leistungsfähigkeit und ermöglichen einen schnellen Einstieg.
Dem stehen jedoch Abhängigkeiten von den jeweiligen Anbietern sowie Fragen der Datenverarbeitung und Informationssicherheit gegenüber.
Gerade für öffentliche Verwaltungen, Gesundheitseinrichtungen und Unternehmen mit hohen Anforderungen an die Vertraulichkeit kann deshalb der Betrieb eigener Sprachmodelle auf einer kontrollierten Infrastruktur interessant sein.
Sogenannte On-Premises-LLMs ermöglichen es, Dokumente und Informationen innerhalb der eigenen IT-Umgebung zu verarbeiten.
Allerdings bedeutet auch der interne Betrieb eines Sprachmodells nicht automatisch, dass sämtliche datenschutzrechtlichen und sicherheitstechnischen Anforderungen erfüllt sind.
Zugriffsberechtigungen, Protokollierung, Verschlüsselung, Modellkonfigurationen und organisatorische Vorgaben bleiben weiterhin erforderlich.
Ich halte daher einen hybriden Ansatz für besonders sinnvoll:
Unkritische oder zuverlässig anonymisierte Informationen können unter geeigneten Rahmenbedingungen mit leistungsfähigen externen Sprachmodellen verarbeitet werden.
Besonders vertrauliche oder sensible Informationen sollten hingegen bevorzugt innerhalb einer entsprechend abgesicherten und kontrollierten IT-Infrastruktur verbleiben.
Damit lässt sich die Leistungsfähigkeit externer KI-Systeme nutzen, ohne auf die Kontrolle über sensible Informationen verzichten zu müssen.
8. Meine Empfehlungen aus Sicht des IT-Sachverständigen
Aus meiner Sicht sollten Organisationen für die berufliche Nutzung generativer KI klare technische und organisatorische Rahmenbedingungen schaffen.
Dabei halte ich insbesondere folgende Maßnahmen für wesentlich:
- Verbindliche KI-Nutzungsrichtlinien: Mitarbeiter müssen wissen, welche Daten in welchen KI-Diensten verarbeitet werden dürfen.
- Datensparsamkeit als Grundprinzip: An externe KI-Systeme dürfen nur jene Informationen übermittelt werden, die für die jeweilige Aufgabe tatsächlich erforderlich und deren Verarbeitung zulässig ist.
- Anonymisierung und Pseudonymisierung: Wo möglich, sollten schützenswerte Informationen bereits vor der Übermittlung systematisch entfernt oder ersetzt werden.
- Technische Schutzmechanismen: Zentrale KI-Gateways, Datenklassifizierung und automatisierte Prüfungen können dazu beitragen, unbeabsichtigte Datenabflüsse zu verhindern.
- Prüfung der externen Anbieter: Verträge, Datenverarbeitungsbedingungen, Speicherfristen, Drittlandübermittlungen und Sicherheitsmaßnahmen müssen vor der Freigabe bewertet werden.
- Sensibilisierung der Mitarbeiter: Informationssicherheit muss Bestandteil der praktischen KI-Kompetenz werden.
- Interne KI-Infrastrukturen: Für besonders sensible Anwendungsfälle sollten geeignete interne oder anderweitig kontrollierte KI-Lösungen geprüft werden.
Dabei ist zu berücksichtigen, dass selbst eine erfolgreiche Pseudonymisierung weder die Notwendigkeit einer Rechtsgrundlage noch weitere DSGVO-Verpflichtungen entfallen lässt.
9. Fazit: Nicht die KI ist das Risiko, sondern der unkontrollierte Umgang mit Informationen
Generative künstliche Intelligenz bietet Unternehmen, öffentlichen Verwaltungen und Sachverständigen enorme Möglichkeiten.
Sie kann Prozesse beschleunigen, die Qualität von Analysen verbessern und Mitarbeiter bei komplexen Aufgaben unterstützen.
Die entscheidende Herausforderung liegt jedoch darin, diese Möglichkeiten mit den Anforderungen an Datenschutz, Vertraulichkeit und Informationssicherheit in Einklang zu bringen.
Aus meiner Sicht wäre es der falsche Ansatz, leistungsfähige KI-Systeme aus grundsätzlichen Sicherheitsbedenken vollständig aus dem Berufsalltag auszuschließen.
Ebenso falsch wäre es allerdings, sämtliche verfügbaren Informationen unkontrolliert an externe Sprachmodelle zu übermitteln.
Der richtige Weg liegt in einem bewussten, technisch abgesicherten und organisatorisch geregelten Einsatz.
Anonymisierung und Pseudonymisierung sind dabei keine Hindernisse für die Nutzung künstlicher Intelligenz. Sie sind wesentliche Bausteine, um diese Technologie verantwortungsvoll und nachhaltig einsetzen zu können.
Denn letztlich gilt ein Grundsatz, der für die gesamte Informationssicherheit von zentraler Bedeutung ist:
„Die sichersten Daten sind jene, die ein externes System gar nicht erst erhalten hat.“